在全球醫療體系同時面臨高齡化、醫療人力不足與財務壓力的時刻,AI 被寄予厚望,彷彿只要導入演算法與大數據,就能一舉解決難題。然而,來自跨國藥廠賽諾菲(Sanofi)的全球數位醫療副總裁 Jared Josleyn,近日在「全球智慧醫療創新高峰會:AI 數據經濟與價值導向的醫療創新」上,卻選擇踩剎車,提醒全球醫療界與科技產業:AI 正站在一個關鍵轉折點上。
他不只談演算法,更談「經濟模型」與「權力分配」——尤其是,那些真正掌握健康命運、卻長期被忽略的數據:人們生活、工作、飲食、睡眠與壓力的軌跡。透過他主導的「Project Saturn(土星計畫)」,Josleyn 嘗試回答一個根本問題:醫療 AI 的價值,究竟應該回到誰的手中?
從視覺錯覺說起:我們其實一直「看錯了」數據世界

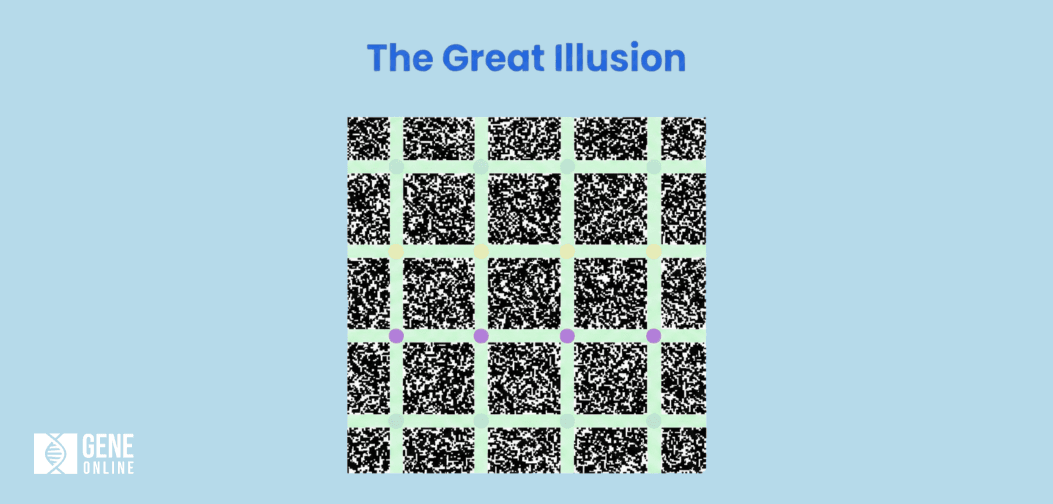
演講一開始,Josleyn 並沒有立刻丟出艱深的技術名詞,而是請在場觀眾看一張視覺錯覺圖片:如果用餘光看,會以為中心有顏色的點,但當你試著聚焦,它們卻消失不見。
他解釋,這些顏色其實從未存在,是大腦「自行補上」的幻象。這個小實驗是他對整場演講的鋪陳——在 AI 這場全球狂熱中,人們也常被幻象蒙蔽:以為資料不夠、以為只要再買更多算力與雲端,再收購幾家資料公司,就能無限推進 AI 的邊界。
但 Josleyn 指出,現實其實相反:資料不是不存在,而是被鎖住;被誤用的,其實不是技術,而是我們看待資料與價值分配的方式。
AI 正撞上「資料窗」:5 兆美元投資,可能只是踩在如空氣般薄弱的基礎上
根據他引用的資料,人類公開可用的高品質文字數據,在大型語言模型(LLM)的瘋狂訓練之下,預計在 2027 至 2028 年就會被吃光。他把這個現象稱作「資料窗」(data window):在一開始的階段,只要餵入更多資料,模型表現就會顯著提升,大家也因此瘋狂追逐資料、擴建算力;然而當現有高品質資料被用盡,新資料變得極度昂貴、難以標註、取得困難,模型效能的提升就會開始趨緩甚至停滯,整體投資報酬率迅速下降。
與此同時,全球正投入難以想像的資金建構 AI 生態:從晶片到數據中心,投資額累計恐怕將達到 5 兆美元等級。對他來說,問題已經不再是「我們如何從 AI 賺錢?」,而是「當這個泡沫破掉時,誰有足夠的基礎,不會被一起拖下水?」他提到,包括 OpenAI 在內的企業,已經為了取得訓練素材,花費數億美元收購遊戲實況與影片資料庫,這種模式在經濟上並不永續。
在這樣的背景下,醫療產業要談 AI,不只是跟風導入工具,而是必須先想清楚:在資料成本飆升、算力競賽白熱化的時代,是否有更穩健也更公平的路線。
醫療真正的金礦,不在醫院裡!那到底在哪裡?
如果現有的公開文字資料即將見底,醫療產業還有機會嗎?Josleyn 的答案是肯定的——但前提是,我們得把目光從病歷系統挪開。
簡報中的一組數字,清楚揭示了問題所在:傳統「臨床照護」(clinical care)只決定了大約 15% 的健康結果;相較之下,社會健康決定因子(Social Determinants of Health, SDOH)大約佔 40%,個人行為(飲食、運動、睡眠、壓力等)則約佔 20%。換句話說,接近六成的健康結果,其實取決於醫院外的世界——人們住在哪裡、工作環境如何、是否能吃到健康的食物、能不能安全地運動,以及平常承受多少壓力。
在數據量上,落差更驚人。一個人一生的臨床資料,大約只有 0.4 TB;但與生活、行為、環境相關的資料,則高達 1,100 TB,是前者的 2,750 倍。Josleyn 形容,這是人類歷史上最大的「未充電電池」。這些資料並不是來自貓咪影片或社群網站,而是來自人真正如何生活、工作、吃、動、睡與恢復的軌跡。
然而,這顆巨大的「能量電池」並沒有被接上線。問題不在技術,而在經濟模式與信任機制——每個掌握資料的角色,都在防守,而不是共創。他提醒,若醫療產業只盯著醫院內的那一小塊資料,而忽視生活情境中龐大的資訊,就好像只看冰山露出水面的那一角,卻從未真正理解整座冰山的重量與方向。
「這不是你的資料」,談談保護與產出的錯位
為了說明這種防禦心態,Josleyn 以美國自己的家鄉伊利諾州為例。
當地近期通過一項關於 AI 與心理健康的立法,禁止 AI 自行提供心理治療、開立治療計畫或進行診斷。立法者的出發點,是擔心演算法取代專業治療師,傷害病人安全。對此,他並不反對,甚至強調在醫療裡,安全絕對是第一優先。
但他點出,真正的問題藏在立法者後來的一段說法中——有議員在訪談中說:「資料是臨床醫師最珍貴的資產,我們必須保護它。」此時,Josleyn 在台上停頓了一下,丟出一句話:「但那其實不是你的資料,那是病人的。」
在他看來,許多自稱是「為了病患著想」的保護論述,實際上保護的是醫療機構本身,而非資料真正的擁有者——民眾。醫院往往把資料視為競爭優勢,擔心一開放就失去差異化;保險與支付方則憂慮理賠與申報資料一旦揭露,會影響談判籌碼與成本結構;企業普遍採取零和思維,覺得「如果我把資料給你,你賺到的就是我失去的」;社區與病人則在一次次「被取用卻無回饋」的經驗後,自然不再願意分享;監管者在缺乏更好工具時,往往傾向選擇封鎖、集中與嚴格限制。
結果,所有人都說要「保護病人」,但實際行為卻是各自築高牆,把資料緊緊鎖住。他直言,這是一種「保護優先、生產其次」的思維:先護城河,再談創新。長期下來,真正被犧牲的,反而是本來可以用這些資料改善健康的機會。
從利益少數的「提取經濟」,走向利益大眾的「生產經濟」

在傳統數據經濟裡,科技巨頭與大型平台掌握管道,負責「提取」(extract)資料,然後轉化成商業價值。在這種「提取經濟」(extraction economy)模式下,價值會高度集中在少數平台與科技公司身上,個人與社區則多半是「被挖掘者」,而不是參與者;隱私與獲利常被視為衝突,只能在保護與開放之間二擇一。
Josleyn 提出的替代方案,是在 AI 時代建立一套新的「生產經濟」(production economy)。在這個模式中,資料不再只是被平台提取,而是由個人與社區共同生產、共同治理,並且共同分享成果。隱私保護與商業價值不再對立,而是透過技術設計與治理結構被精心對齊;AI 的價值也不再只能集中在少數雲端巨頭,而是回到每一位提供資料的人身上。
他甚至挑戰經濟學之父亞當史密斯:「在工業時代,國家財富來自勞動分工;在 AI 時代,國家的新財富則來自『資料的生產』。」換句話說,那些能讓人民安全且有尊嚴地參與資料生產與價值分配的國家與醫療體系,才有機會在未來的醫療數據經濟中站穩腳步。
Saturn 計劃核心精神是讓 AI 去找資料,而不是把資料搬走

要從提取經濟走向生產經濟,關鍵在於:我們能否在「不搬動資料」的前提下,讓 AI 仍然能學習、推論並創造價值?這就是 Josleyn 在會中提出的核心方案——Project Saturn(土星計畫)。
Saturn 的核心精神,是建構一個以「個人」與「個人 AI 代理人(personal agent)」為主體的生態系統,並建立三大基礎。首先是治理基礎(Governance),以「隱私即設計」(privacy-by-design)為原則,讓病人對資料擁有清楚的同意權與使用透明度,同時保證社區與在地機構具有主權,而非被動的資料提供者。
其次是經濟基礎(Economic),透過智慧合約與代幣化等方式,設計公平的價值交換機制,不只大型企業能從中獲利,參與提供資料與治理的個人、醫療機構與社區,也能在價值循環中得到實際回報。
最後是技術基礎(Technical),採用「垂直聯邦學習」(Vertical Federated Learning)以及可信執行環境(TEE)等技術,讓 AI 能夠「走向」資料所在之處進行運算,資料本身則不必離開原本所在的國家、醫院或系統。
在這樣的架構下,多方異質資料源之間仍能進行特徵對齊與標準化,但過程中不需暴露原始紀錄。他以簡單的類比說明:就像你可以拿著望遠鏡看自己的第二間房子,但房子並沒有被搬到你身邊。同樣地,在 Saturn 模式下,研究者可以「看到」分析結果與模型表現,卻永遠無法直接接觸到任何一筆個人的原始健康紀錄。
從糖尿病預測到真實世界資料,是 Saturn 成功的實證
這套架構並非紙上談兵。根據簡報內容,團隊已經在多個國際合作案例中驗證 Saturn 模式的可行性,其中一個重點場景,是針對第一型糖尿病(T1D)高風險族群的預測與早期介入。
在傳統作法中,若要結合藥廠、國際醫學中心、區域醫院與保險方的資料,至少會遇到四道厚牆:首先是法規限制跨境與跨機構資料移轉,例如 GDPR 等規範帶來的合規壓力;其次是醫療機構彼此之間存在競合關係,很難真正放心地共享數據庫;再來是社區與病人對「資料被抽走」高度敏感,擔心一旦資料離開自己能掌握的範圍,就會被濫用;最後則是技術標準不一,讓資料整合成本極高,往往耗時耗力卻收效有限。
在 Saturn 模式下,團隊的做法完全不同。他們讓各機構維持資料主權,數據留在原本的資料庫與國家,由各方自己掌控;透過垂直聯邦學習,模型在各節點本地訓練,最後再彙整參數與結果,而非直接交換原始資料;在資料傳輸與轉換過程中,則使用可信執行環境進行特徵對齊與轉換,減少人工介入與暴露原始資料的風險。
結果顯示,在不集中資料的前提下,模型在預測無症狀 T1D 高風險個案上的表現,與傳統「把資料全部拉在一起」的作法幾乎一致,甚至能大幅降低需要追蹤的陽性個案比例,從過去約 300 比 1 降到 11 比 1 左右,大大提升介入效率。更重要的是,這些價值並非只回到單一公司或單一醫院,而是各參與方——包含醫院、社區與病人——都能在生產迴圈中實際受益。
「我在 Google 工作過,但他們從沒寄過支票給我」
談到資料價值分配時,Josleyn 半開玩笑地說,他曾在 Google 工作,也頻繁使用平台服務,提供大量使用紀錄,但「我從來沒收到過他們的支票」。這句話背後,是對現行網路經濟的一種反諷:用戶每天貢獻資料與注意力,平台則把這些資料轉化為廣告與商業利潤,而真正提供「原料」的大眾,幾乎得不到任何直接回報。
在 Saturn 與生產經濟的構想中,他希望換一個世界:當社區與個人選擇分享健康相關資料時,不再只是被動地被「挖」;而是能透過清楚的合約與透明機制,明確知道資料用在何處、創造了多少價值,並在這個價值裡獲得一部分回饋。對醫療體系而言,這樣的模式或許也是一種生存策略——面對 AI 投資泡沫與成本壓力,單靠節省成本已經不夠,需要的是全新的收入結構與價值創造方式。
他提醒,若 AI 只是一個新的「提取工具」,只是換了一個更聰明的方式挖掘更多資料、集中更多利益,那麼醫療的不平等只會被放大;只有當資料的生產者與貢獻者被正式納入價值分配的架構裡,AI 才有可能成為促進健康與公平的力量,而不是加深裂縫的工具。
善用分散、可信、可持續的智慧網路,不一定要燒掉 5 兆美元集中投資
有趣的是,Josleyn 並不迷信「越大越好」的算力崇拜。他提到,隨著手機晶片與邊緣運算能力暴增,許多 AI 模型其實已經可以在個人裝置上執行。以最新一代的手機晶片為例,許多過去只能在大型伺服器上跑的模型,現在已經可以在手機、平板甚至穿戴式裝置中運作。
在他描繪的未來,並不是所有事情都必須仰賴巨大資料中心與雲端;分散式運算與本地 AI 將成為新常態。病人的手機、家用裝置,甚至睡眠偵測器、血糖監測器等穿戴式設備,都可以成為 AI 的「節點」;存在於裝置上的個人代理人(personal agent)可以在本地處理高度敏感的健康資料,只把必要的統計與參數送回 Saturn 網路,參與模型訓練與更新。
這種方式既減少隱私風險,也有助於降低 AI 對大型資料中心與能源的依賴,讓 AI 的部署更具永續性。他強調,未來不一定需要 5 兆美元的集中式投資,真正關鍵的是如何設計一個分散、可信、可持續的智慧網路,把運算與價值創造帶到人們實際生活的場景中,而不是只停留在遙遠的雲端。
創造多贏,從「我怎麼保護自己」到「我們怎麼一起變好」
在演講尾聲,Josleyn 把話題拉回一開始的核心問題。他說,如果你站在醫院、保險公司或政府的角度,很直覺會問的是:「我要怎麼保護自己?」但作為一個看著家人進出醫院的普通人,他會說——那是錯的問題。
他認為,真正該問的,是我們如何讓每一個參與者,都能從資料中獲得價值;我們如何設計一個參與制度,讓合作比封閉更有競爭力;我們又如何用資料改善健康,而不是只拿來鞏固市場地位。當醫療體系只問「我要怎麼保護自己?」,自然就會傾向築牆、關門、鎖資料;但如果改問「我們怎麼一起變好?」,思路就會轉向如何創造誘因、設計機制,讓大家願意加入同一個生態系。
在他描繪的未來裡,醫療體系不再只是「服務提供者」,社區也不只是「被管理的對象」。社區會是經濟的參與者,而不只是被動接受 AI 的一方;病人不只是「個案」,而是擁有資料主權的合作夥伴;生產力與創新能力則被分散到各個節點,而不是集中在少數科技巨頭手中。當這樣的生產迴圈形成——健康社區產生更好的資料、更好的資料訓練更好的 AI、更好的 AI 創造更多價值、價值再回流改善健康——醫療保健才有可能真正從零和博弈,走向多方共贏。
在這個過程裡,Saturn 只是開始,真正難的,是每一個利害關係人是否願意改變那句習慣性的問句:從「我怎麼保護自己?」變成「我們怎麼一起變好?」
AI 醫療創新的下一步,或許不是「更聰明」,而是「更公平」
從視覺錯覺的圖像,到 1,100 TB 的社會行為數據,再到 Saturn 的聯邦學習架構與生產經濟藍圖,Jared Josleyn 在臺灣的這場分享,乍看談的是 AI 與大數據,但骨子裡談的是權力、信任與分配。
在 AI 被視為「萬靈丹」的當下,他選擇提醒各國政府、醫院、產業與社區:如果我們只想著如何保護自己的城牆,AI 最終只會加深既有的不平等;如果我們願意重組經濟與治理模式,讓價值真正回到資料的原始擁有者,AI 才有機會成為醫療公平與健康促進的引擎。
這或許正是「AI 數據經濟與價值導向醫療創新」最關鍵的一課:下一階段的競爭,不只是誰的模型更大、誰的晶片更快,而是誰能先打造一個,讓所有人都願意打開資料、一起變好的生態系。當 AI 不再只是新的「提取機器」,而是嵌入一個兼顧隱私、公平與永續的生產經濟中,我們才有機會真正看到一個更新、更健康的醫療世界。
而這個世界,或許就從重新回答一個簡單的問題開始:資料到底是誰的?價值又應該回到誰的手裡?
參考來源:
研討會現場紀錄